오버레이 에러를 실리콘 원자 단위 격자의 절반 이내로 예측했습니다.
오버레이 에러 예측을 위한 도메인 지식 기반 융합 머신러닝 모델
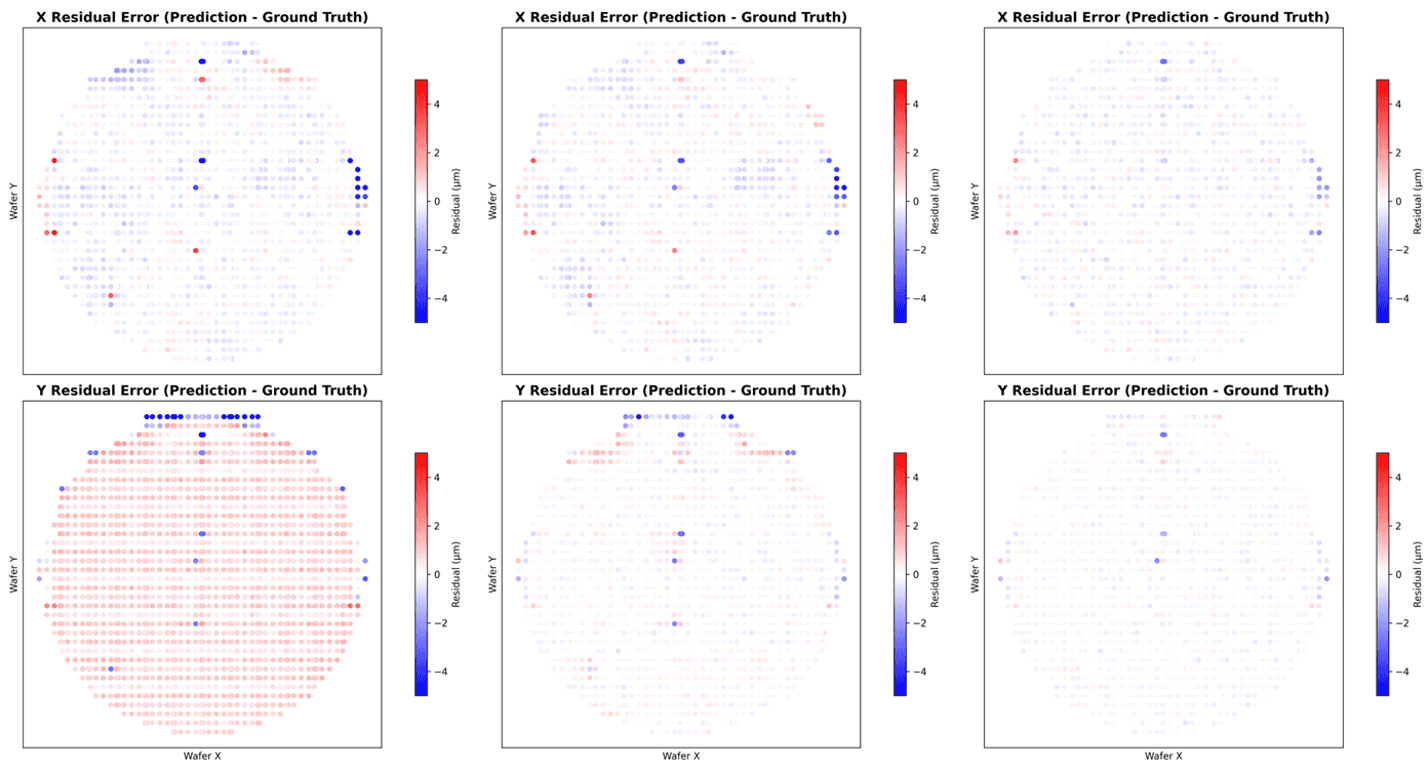
일반적으로 평균 정확도가 높은 오버레이 에러 예측 모델도 특정 에러에 대해서는 전혀 보지 못할 수 있습니다. 스캐너 테이블 마모로 인한 웨이퍼 전역 변형과 오버레이 마크 변형에 의한 국부 변형이 동시에 나타나는 이중 모드 변형(bimodal deformation) 조건에서, 평균 정확도가 높은 것으로 알려진 Linear Regression 및 XGBoost와 당사가 개발한 도메인 지식 기반 융합 모델을 비교했습니다. 당사 모델은 평균 RMSE 0.259nm를 기록했으며, 이는 Linear Regression 대비 78%, XGBoost 대비 46% 낮은 수치입니다. 동시에 Pearson r 0.88 이상을 기록했습니다.
평균 정확도가 잘못된 기준인 이유
제어 정밀도가 sub-1nm 영역으로 좁혀지면서, 피드백에만 의존하는 오버레이 제어 방식으로는 더 이상 충분하지 않게 되었습니다. 지금 요구되는 정밀도는 물리적 계측만으로 확보할 수 있는 수준보다 낮고, 그 격차는 벌어지고 있습니다. 제품 다양화로 인한 공정 산포는 커지는 반면, 계측 처리량은 유지되고 있기 때문입니다.
계측 결과가 결함 예측과 의미 있게 연결되려면 고밀도 샘플링이 필요합니다. 그러나 장비 간 매칭 노이즈와 긴 측정 시간은 양산 팹의 실제 측정 처리량에 명확한 상한을 만듭니다. 그래서 팹은 일부만 측정하고 나머지는 추론합니다. 결국 그 추론의 품질은 수율의 문제가 됩니다.
범용 머신러닝이 조용히 한계를 드러내는 지점이 바로 여기입니다. 일반적인 모델은 평균적인 조건에 맞춰 최적화되고, 평가 역시 같은 방식으로 이루어집니다. 그러나 양산 환경에서 불량 웨이퍼와 그 패턴은 드물게 나타나기 때문에, 학습과 평가에 사용할 데이터에 충분히 담겨 있지 않습니다.
이중 모드 변형이 대표적인 예입니다. 스캐너 테이블 마모에서 비롯된 전역적 신호와 오버레이 마크 변형에서 비롯된 국부적 신호가 같은 웨이퍼에 동시에 나타나는 경우가 그 예시입니다. 각각만으로도 다루기 어렵고, 두 신호가 겹치면 모델이 절반만 학습합니다. 특정 모드는 잡아내고 다른 모드는 놓치면서도, 평균 정확도는 그럴듯한 수준으로 보고되는 것입니다.
양산 데이터가 보여줄 수 없는 것을 사전학습하다
이러한 사례를 학습시킬 때의 걸림돌은 모델이 아니라 데이터입니다. 양산 데이터는 양이 제한적이고 보안에 민감하며, 무엇보다 가장 중요한 신호가 오히려 빠져 있습니다. 드문 불량에 강건한 모델을 만들 만큼 그 사례를 충분히 모으는 것은 불가능합니다. 충분히 모을 수 있다면 애초에 드문 불량이 아니기 때문입니다.
그래서 저희는 그 데이터를 직접 생성합니다. Virtual Fab 환경은 물리적으로 타당한 확률적 패턴을 갖는 대규모 합성 오버레이 데이터를 생성합니다. 양산 데이터에는 충분히 담기지 않는 엣지 케이스를 의도적으로 생성해 학습 데이터에 포함시킵니다. 이렇게 만들어진 데이터는 정상 웨이퍼부터 점진적인 시계열 드리프트, 이중 모드 변형까지를 포함합니다. 이 데이터로 사전학습한 파운데이션 모델은 실제 웨이퍼를 학습하기 전 이미 웨이퍼 내 오버레이 에러 신호의 구조를 이해합니다.
나머지 절반은 이종 입력 데이터를 결합하는 방식에 있습니다. 스캐너 및 장비 로그, 통계적 공정 요약 데이터, 웨이퍼 위치에 따른 공간 특징은 공정 도메인 지식에 따라 융합됩니다. 이 아키텍처는 신호 대 잡음비가 높은 특징을 우선하고, 오버레이 오차가 발생하는 메커니즘을 반영합니다. 덕분에 모델은 실제 신호와 배경 노이즈를 구분할 수 있습니다.
이 차이는 중요합니다. 이것은 데이터 물량에 의존하는 모델이 아니라, 도메인 지식 기반 학습 프레임워크입니다.
벤치마크가 보여준 것
의도적으로 유도한 이중 모드 변형 조건에서 1,400개 샘플로 파인튜닝하고 600개로 검증했으며, 평균 정확도가 높은 것으로 알려진 두 모델과 당사 모델을 RMSE, R², Pearson 상관계수 기준으로 비교했습니다.
| 모델 | RMSE X | RMSE Y | Avg. RMSE | R² X | R² Y | r X | r Y |
|---|---|---|---|---|---|---|---|
| Linear Regression | 0.637 | 1.741 | 1.189 | −0.146 | 0.004 | 0.114 | 0.080 |
| XGBoost | 0.478 | 0.487 | 0.482 | 0.355 | 0.922 | 0.629 | 0.962 |
| 제안 Fusion ML | 0.303 | 0.216 | 0.259 | 0.740 | 0.985 | 0.888 | 0.993 |
RMSE 단위는 nm. 이중 모드 변형 조건, 파인튜닝 샘플 1,400개, 검증 샘플 600개. R²는 1 − SS_res/SS_tot로 정의되며 Pearson r의 제곱이 아닙니다. r²와 달리, 모델이 평균값 기준선보다 못한 경우 음수가 될 수 있습니다.
Linear Regression은 이중 모드 조건에서 예측에 실패합니다. Pearson r이 0.114와 0.080까지 떨어지는데, 이는 모델이 이중 모드 구조를 사실상 전혀 잡아내지 못했다는 뜻입니다. 벡터 맵에서 예측된 크기는 0 ~ 1.8nm에 그치는 반면, ground truth는 0 ~ 0. 8nm에 분포합니다. 약 4배의 과소예측입니다.
더 많은 것을 말해 주는 쪽은 XGBoost 결과입니다. 평균 RMSE 0.482nm는 무난해 보입니다. Y 방향 상관계수 0.962는 훌륭해 보입니다. 그러나 X 방향의 r은 0.629입니다. 특정 변형 모드는 잘 학습했지만 다른 변형 모드는 고전했다는 뜻입니다. 평균값 하나만 봤다면 이 사실은 완전히 가려졌을 것입니다. 공간적으로는 전역 벡터 필드를 복원했지만, 웨이퍼 상단 가장자리 부근에 최대 약 6nm의 잔차가 집중되어 남았습니다.
융합 모델은 두 축 모두에서 안정적으로 유지됩니다. 평균 RMSE는 0.259nm로, Linear Regression 대비 78%, XGBoost 대비 46% 낮습니다. r은 각각 0.888과 0.993이며, 특정 방향의 공간적 편향도 나타나지 않습니다. 잔차 벡터의 최대 크기는 약 3.5nm로 세 모델 중 가장 작습니다. 가장 분명한 증거는 잔차 맵입니다. 오차가 작아졌을 뿐 아니라, 오차에 구조가 남아 있지 않습니다.
이 결과가 의미하는 것
이번 벤치마크 결과는 특정 이중 모드 불량 시나리오에서 얻었지만, 그럼에도 불구하고 의미하는 바가 있습니다. sub-1nm 영역에서 필요한 것은 평균값의 소폭 개선이 아니라, 엣지 케이스 실패를 체계적으로 줄이는 일입니다. 설계 단계부터 공정을 이해하도록 만들어진 모델은 그렇지 않은 모델과 이러한 경우를 다르게 다룹니다. 그리고 그 차이는 정확히 중요한 곳에서 드러납니다. 평균 지표가 가리고 있던 바로 그 방향에서입니다.
지금 사용하시는 오버레이 모델은 평균 뒤에 어떤 실패 모드를 감추고 있습니까?
미세 공정에서 오버레이 제어를 다루고 계신다면, 한정된 데이터셋으로 PoC를 수행할 수 있습니다. 공정, 계측 또는 수율과 관련한 과제에 대해 논의를 원하시면 연락을 부탁드립니다.
본 연구는 SPIE Advanced Lithography + Patterning 2026에서 발표되었습니다(논문 번호 13981-140). 논문 제목: “Domain Knowledge-Driven Fusion Machine Learning for Sub-1nm Overlay Prediction Enhancement.”
